[경제일보] 구글이 자체 AI 반도체 텐서처리장치(TPU)를 대용량 데이터 처리와 보안 등 용도에 맞춰 확대한다. 여러 AI 에이전트가 긴 문서와 영상, 소스 코드를 동시에 분석하면서 커지는 메모리 병목을 줄이고, 금융·공공기관의 민감한 데이터도 처리할 수 있도록 제품군을 세분화했다.
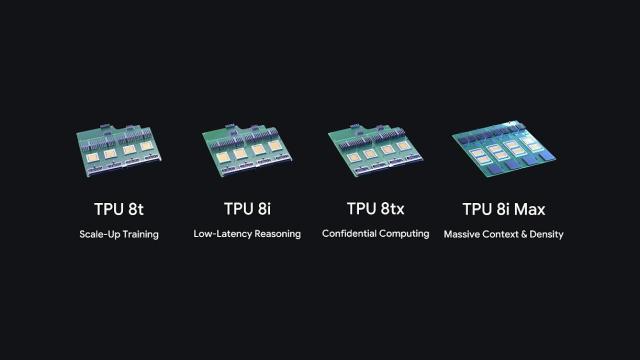
구글은 9일(현지시간) 8세대 TPU 제품군에 ‘TPU 8i Max’와 ‘TPU 8tx’를 추가한다고 밝혔다. 지난 4월 공개한 대규모 학습용 ‘TPU 8t’, 실시간 추론용 ‘TPU 8i’에 이어 한 해 동안 네 가지 시스템을 선보인 것이다.
TPU 8i Max는 기존 TPU 8i 칩 두 개를 하나의 패키지에 결합했다. 구글에 따르면 TPU 8i 대비 연산 성능과 칩 내부 메모리(SRAM) 용량, 고대역폭메모리(HBM) 대역폭이 각각 두 배다. 기존 랙과 같은 설치 면적에 더 많은 연산 자원을 배치할 수 있도록 설계했다.
개발 배경은 AI 에이전트가 한 번에 다루는 정보량의 증가다. 여러 에이전트가 전체 소프트웨어 코드나 수 시간 분량의 영상을 함께 분석하면 연산 능력뿐 아니라 메모리에서 데이터를 가져오는 속도가 중요해진다. 구글은 연산과 메모리 대역폭을 함께 늘려 대규모 작업 중 처리 장치가 데이터를 기다리는 시간을 줄이겠다는 구상이다.
‘두 배’는 TPU 8i 한 개와 비교한 하드웨어 자원 기준이다. 실제 서비스의 처리 속도는 모델과 입력 길이, 소프트웨어 구성 등에 따라 달라진다.
TPU 8tx는 학습용 TPU 8t와 같은 칩에 맞춤형 AMD 중앙처리장치(CPU)를 조합한 시스템이다. 규제가 엄격한 기업과 정부기관이 민감한 데이터, 자체 모델, AI 에이전트를 함께 운영하는 환경을 겨냥했다.
주요 기능은 데이터를 연산하는 동안에도 하드웨어 수준에서 보호하는 ‘기밀 컴퓨팅’이다. 저장하거나 전송할 때뿐 아니라 실제 처리 과정에서도 데이터와 모델 가중치를 격리하도록 설계했다. 구글은 저지연 네트워크를 적용해 TPU 8t 대비 지연시간도 최대 절반으로 줄였다고 설명했다.
기업은 같은 클러스터에서 내부 데이터로 모델을 미세 조정하거나, 대형 모델의 능력을 소형 모델로 이전하는 증류, 에이전트 강화학습 등을 수행할 수 있다. 작업 단계마다 민감한 데이터를 별도 클러스터로 옮기는 부담을 줄이는 방식이다.
하드웨어 확대와 함께 소프트웨어 전환 비용도 낮추고 있다. 구글은 지난달 20일 메타의 파이토치팀과 공동 개발한 ‘토치TPU(TorchTPU)’를 오픈소스로 공개했다. 기존 파이토치(PyTorch) 작업을 익숙한 개발 도구와 API로 TPU에서 실행하도록 지원한다.
공식 설명은 ‘코드 수정 없이’가 아닌 ‘최소한의 코드 변경’이다. 구글은 모델 배포 도구와 분산 학습 프레임워크 연동도 확대해 개발자가 업무별로 GPU·TPU·CPU를 선택할 수 있도록 하고 있다.
TPU는 구글 내부 서비스용 반도체에서 외부 고객을 위한 사업으로 커지고 있다. 구글은 제미나이 학습·서비스와 클라우드 제공에 더해 고객 데이터센터에 TPU를 직접 배치하는 방식도 지원하고 있으며, AI 연구기관·금융사·유통업체·대학 등 고객이 100곳에 육박한다고 밝혔다.
Copyright © 경제일보, 무단전재·재배포 금지