[경제일보] "단순한 토큰 단가가 아니라 고객이 하려는 업무를 얼마나 적은 비용으로 처리할 수 있느냐를 지향한다"
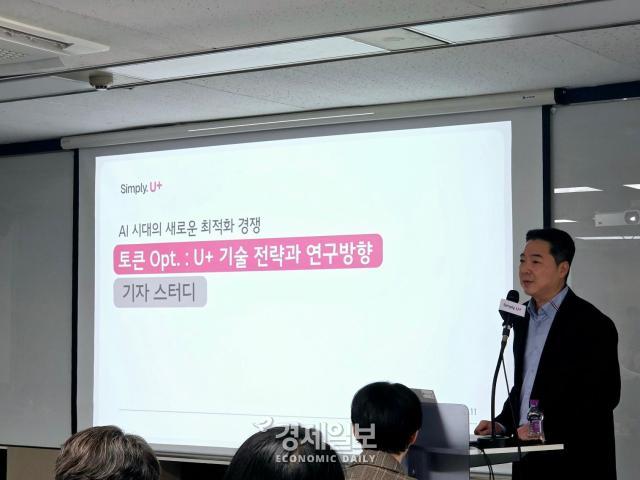
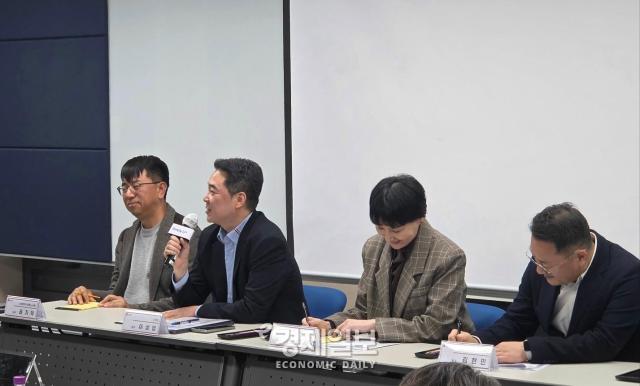
지난 12일 이상엽 LG유플러스 CTO는 기자들을 대상으로 연 'AI 토큰 최적화 스터디'에서 향후 개발 방향을 발표하며 이같이 말했다. 이날 이혜진 기술전략담당, 권기덕 AX엔지니어링Lab장, 김현민 소버린클라우드사업팀장도 발표와 질의응답에 나섰다.
LG유플러스는 이날 '익시오'와 AI 고객센터(AICC), 사내 업무 혁신(AX)에서 쌓은 토큰 최적화 기술로 내년부터 기업 고객의 AI 운영 비용을 낮추는 토큰 사업에 나서겠다는 청사진을 제시했다. 코딩 영역에서 자체 AI 모델로 운영 비용을 약 90% 줄인 사례를 확인했고, 같은 인프라에서 처리 효율을 약 4배 끌어올렸다는 설명이다. 비용 부담에 AI 도입을 망설이는 기업(B2B) 시장을 '업무 한 건을 끝내는 데 드는 총비용'으로 공략하겠다는 전략이다.
토큰은 AI가 질문을 이해하고 답을 내는 데 쓰는 글 조각 단위다. 이혜진 담당은 "AI를 켜면 토큰이 흐른다"며 토큰이 전기·가스·수도·통신처럼 인프라 영역에 들어왔다고 설명했다.
LG유플러스에 따르면 1년 새 토큰 비용은 80% 싸졌지만 빅테크 기준 소비량은 3배로 늘었다. 사람 대신 AI 에이전트가 AI를 쓰기 시작하면서 에이전트가 쓰는 토큰은 사람의 14배를 넘었다. 단가가 내려도 전체 지출은 오히려 커진다는 것이다.
이 담당은 "지금까지는 더 똑똑한 모델의 경쟁이었다면 이제는 동일한 업무를 얼마나 적은 토큰으로 제대로 해낼 수 있느냐의 전쟁이 시작됐다"며 "기본적인 비용을 줄이는 것도 굉장히 중요하지만 내가 하고자 하는 일을 사람을 온전히 덜어 덜어 내더라도 움직일 수 있는 정도의 결과를 어떻게 빨리 뱉어낼 수 있는가의 전쟁이 시작됐다"고 평가했다.
권기덕 Lab장은 질문에 맞는 모델을 골라 보내는 '모델 라우팅', 모델을 가볍게 만드는 경량화, 여러 반도체를 섞어 쓰는 '칩믹스(Chip-Mix)'를 LG유플러스의 토큰 절감의 핵심 기술로 소개했다. 내부 테스트에서 모델 라우팅으로 일반 질문은 25% 이상, 코딩 에이전트는 30% 이상 비용을 줄였다.
경량화로는 익시오의 온디바이스 모델 크기를 2.4~3GB에서 800MB로 약 3분의 1로 줄이면서 비교 대상 클라우드 모델 대비 95% 이상의 성능을 냈다. 작은 모델이 먼저 답을 쓰고 큰 모델이 검증하는 '추측 디코딩'으로 토큰 생성 속도도 2배 이상 높였다. 이 연구로 AI 학술대회 '뉴립스(NeurIPS)'에 논문 2편이 채택됐다.
권 Lab장은 추측 디코딩을 신입 기자와 편집장에 빗댔다. 그는 "큰 모델이 하나를 모두 다 생산하면 답변도 품질도 좋겠지만 토큰 효율화 입장에서는 큰 모델의 모든 것을 다 하면 비용이 당연히 올라가게 된다"며 "신입 기자가 기사를 빠르게 적어 내고 편집장은 검수만 하게 되면 기사를 완성하는 속도가 엄청나게 올라갈 수 있다"고 설명했다.
칩믹스는 작업 성격에 따라 반도체를 나눠 쓰는 방식이다. 질문을 이해하는 '프리필'은 연산이 빠른 엔비디아 GPU가, 답을 만드는 '디코딩'은 메모리가 큰 AMD GPU가 맡는 식이다. 국산 AI 반도체 기업 퓨리오사AI와는 2년 이상 협력하며 신경망처리장치(NPU)를 검증하고 있다.
LG유플러스는 통신사의 강점으로 실제 서비스를 운영하며 얻은 '레시피'를 꼽았다. 익시오는 출시 초기 LG AI연구원과 함께 만든 온디바이스 모델에 고난도 추론은 구글 제미나이를 함께 썼다. 이후 자체 모델 비중을 늘리면서 트래픽이 자체 모델 쪽으로 옮겨왔다.
사내에서도 개발자들의 토큰 사용량이 3배 이상 늘자 여러 레시피를 적용해 90% 이상 절감하는 개념검증(POC)을 했다. 개발자가 쓰는 외부 코딩 에이전트의 화면은 그대로 두고, 뒤에서 연결되는 모델만 자체 모델 플랫폼으로 바꾸는 방식이다.
빅테크와의 경쟁을 묻는 질문에 이 CTO는 "토큰 최적화의 경쟁 상대는 빅테크의 모델이 아니다"라고 답했다. 고객 업무에 맞으면 빅테크의 경량 모델로도 라우팅해 더 싼 비용으로 처리하게 해주는 것이 목표라는 설명이다.
이혜진 담당은 고객이 얻는 것으로 체감 가격을 들었다. 그는 "누릴 수 없었던 초고성능 AI를 커피 한 잔 값으로 누리면 좋겠다"며 "기업 고객에게는 지금 '돈 먹는 하마'인 AI를 진짜 일하는 직원으로 만드는 것이 가장 필요한 혜택"이라고 말했다.
사업은 내년부터 본격화한다. 김현민 팀장은 협력사와의 제휴 방식과 자체 인프라 구축 방식으로 고객의 총소유비용(TCO)을 낮추는 토큰 사업을 추진한다고 설명했다.
올 연말 카카오와 함께 상용화하는 '모두의 AI'도 레시피를 쌓는 무대다. 이 CTO는 "프런트는 카카오가 하지만 모델 서비스 영역은 우리가 진행한다"며 여기서 나온 최적화 방법을 토큰 사업 기술에 반영하겠다고 설명했다.
이 CTO는 "LG유플러스의 토큰 최적화는 이론적 효율화를 넘어, 이미 수많은 실전 서비스에서 검증을 끝낸 즉시 전력감 기술"이라며 "글로벌 수준의 모델 경량화·추론 기술과 AI 업무 수행 궤적을 반영한 운영 레시피를 결합해, 내년부터 기업 고객들이 가장 합리적인 비용으로 최고의 AI 성과를 낼 수 있도록 시장을 주도해나가겠다"고 말했다.
Copyright © 경제일보, 무단전재·재배포 금지